Was bedeutet Hochverfügbarkeit in der Industrie?
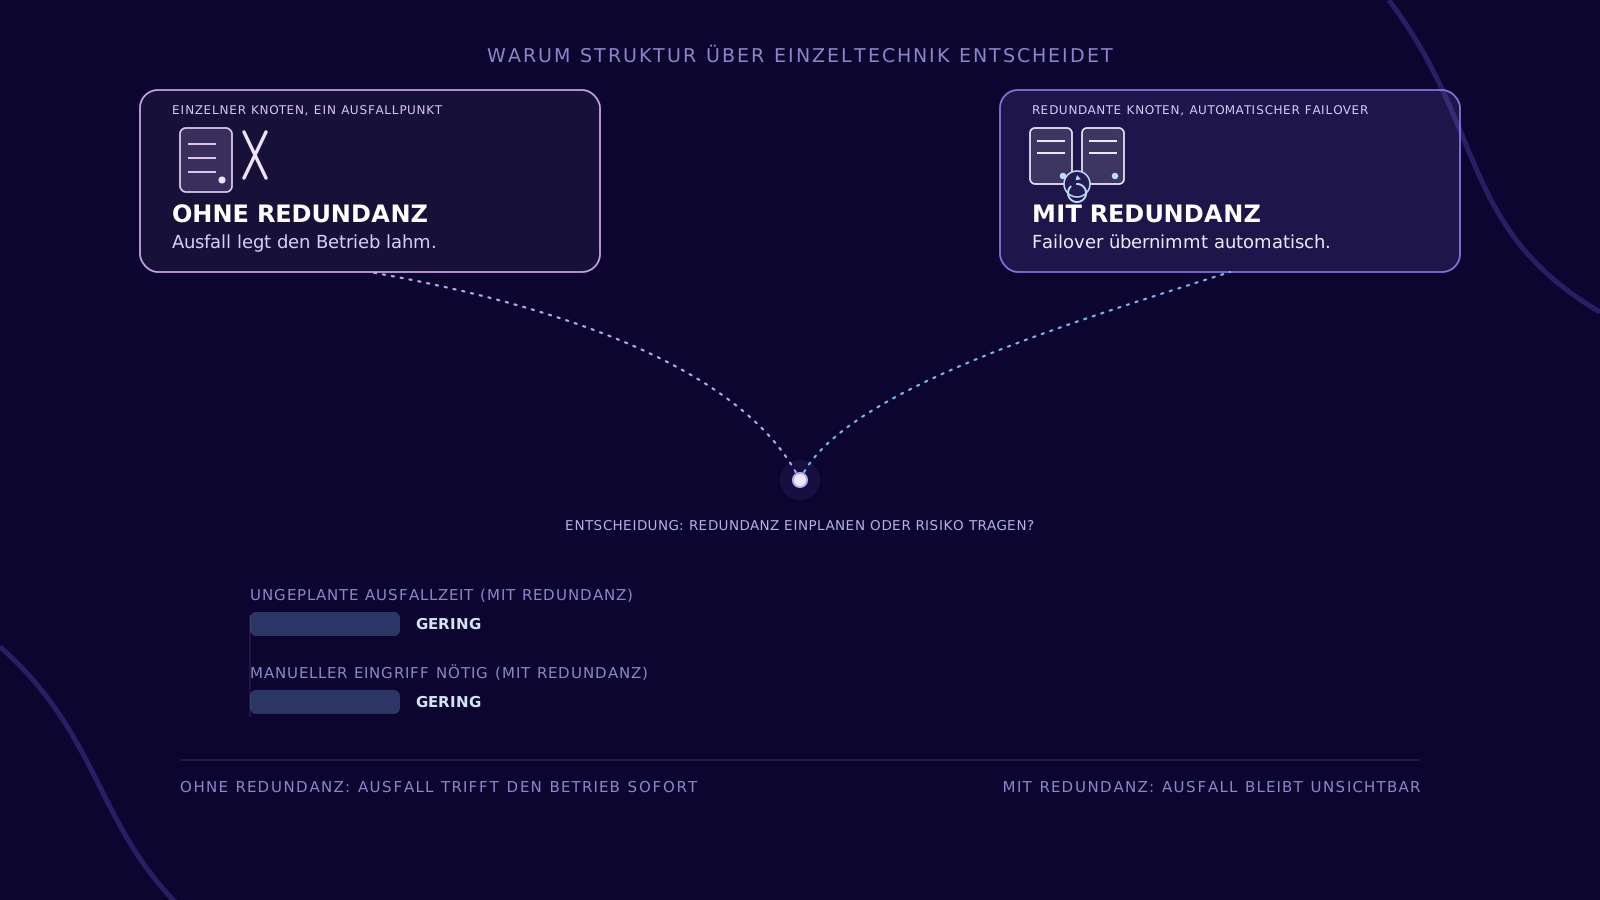
Hochverfügbarkeit bedeutet, dass IT-Systeme Ausfälle abfangen, bevor sie im Betrieb spürbar werden. Sie entsteht aus dem Zusammenspiel von Redundanz, automatisiertem Failover und Lastverteilung — eingebettet in einen transparenten, gut überwachten Betrieb. Für Produktionsunternehmen bedeutet das: Störungen bleiben unsichtbar, statt Produktivität, Umsatz und Kundenvertrauen zu gefährden.
Hochverfügbarkeit als geschäftliche Notwendigkeit
Hochverfügbarkeit ist heute keine rein technische Disziplin mehr, sondern ein zentraler Faktor für den Geschäftserfolg. Sobald IT-Systeme ausfallen, geraten Prozesse ins Stocken, Mitarbeitende können nicht arbeiten und Kunden verlieren schnell das Vertrauen. In vielen Produktionsunternehmen ist die IT längst das Rückgrat des gesamten Geschäftsmodells.
Für CIOs bedeutet das: Verfügbarkeit entscheidet direkt über Produktivität, Umsatz und Reputation. Hochverfügbarkeit sorgt dafür, dass Störungen nicht unmittelbar spürbar werden und das Business auch dann handlungsfähig bleibt, wenn im Hintergrund etwas nicht nach Plan läuft.
Technische Grundlage: Redundanz, Failover, Lastverteilung
Im Kern basiert Hochverfügbarkeit auf klaren Prinzipien. Redundanz stellt sicher, dass kritische Komponenten nicht zum Single Point of Failure werden. Automatisierte Failover-Mechanismen übernehmen Aufgaben, ohne dass IT-Teams unter Zeitdruck eingreifen müssen. Ergänzt wird dies durch Lastverteilung, die Systeme gleichmäßig auslastet und gleichzeitig Performance und Verfügbarkeit verbessert.
Entscheidend ist dabei nicht die einzelne Technologie, sondern das Zusammenspiel aller Komponenten innerhalb einer sauberen Architektur.
Beispiele aus der Praxis
MES- und SCADA-Cluster mit Hot-Standby: Fällt der aktive Knoten aus, übernimmt ein zweiter Knoten in Sekunden, ohne dass die Fertigung stehen bleibt.
Datenbank-Replikation über zwei Rechenzentren: Produktionsdaten werden synchron oder nah-synchron gespiegelt, sodass ein Standortausfall keine Daten kostet.
Load Balancer vor Web- und API-Schicht: Anfragen werden auf mehrere Instanzen verteilt, ein einzelner überlasteter oder ausgefallener Server fällt nicht auf.
Redundante Netzwerkpfade: Zwischen Werkshallen, Leitstand und Rechenzentrum sorgen zwei unabhängige Verbindungen dafür, dass ein Kabel- oder Switch-Ausfall die Kommunikation nicht unterbricht.
Betrieb, Transparenz und Kontrolle
Hochverfügbarkeit endet nicht mit dem Design der Architektur. Erst im laufenden Betrieb zeigt sich, wie stabil Systeme wirklich sind. Kontinuierliches Monitoring schafft Transparenz über den Zustand aller kritischen Komponenten und ermöglicht es, Abweichungen frühzeitig zu erkennen, bevor sie zu Ausfällen führen.
Das reduziert Eskalationen und ermöglicht eine deutlich bessere Planbarkeit von Wartung und Weiterentwicklung. Klare Betriebsprozesse, definierte Verantwortlichkeiten und ein hohes Maß an Automatisierung sind dabei genauso wichtig wie die eingesetzte Technik.
Hochverfügbarkeit im Cloud-Zeitalter
Mit Cloud- und Hybrid-IT hat sich der Fokus verschoben: weg von einzelnen Servern, hin zu durchgängigen Services und Geschäftsprozessen. CIOs denken heute in End-to-End-Verfügbarkeiten und setzen auf verteilte Architekturen, um Abhängigkeiten zu reduzieren.
Richtig umgesetzt wird Hochverfügbarkeit dadurch flexibler, skalierbarer und besser an die Anforderungen des Geschäfts angepasst. Sie wird zum Enabler für Wachstum, Innovation und digitale Resilienz.
Was Hochverfügbarkeit nicht ist
Kein Ersatz für Backup und Disaster Recovery: Hochverfügbarkeit fängt kurzfristige Ausfälle ab, ersetzt aber keine Datensicherung für den Fall eines größeren Vorfalls. Recovery Time und Recovery Point Objective bleiben eigene Größen.
Keine automatische Eigenschaft der Cloud: Ein Cloud-Provider garantiert die Verfügbarkeit seiner Infrastruktur, nicht die Verfügbarkeit der eigenen Anwendung. Ohne redundante Architektur bleibt auch ein Cloud-Workload ein Single Point of Failure.
Kein einmaliges Projekt: Architektur, Monitoring und Failover-Tests müssen kontinuierlich gepflegt werden. Wer Hochverfügbarkeit einmal baut und dann sich selbst überlässt, verliert sie mit jedem Systemwechsel wieder.
Typische Hürden in der Praxis
Legacy-Systeme ohne Cluster-Fähigkeit: Viele gewachsene Anlagen und Anwendungen wurden nie für Redundanz konzipiert und lassen sich nur mit Aufwand nachrüsten.
Kosten-Nutzen-Abwägung: Volle Redundanz kostet Geld. Entscheidend ist, kritische Komponenten zu identifizieren und Verfügbarkeit dort zu investieren, wo ein Ausfall wirklich weh tut.
Fehlende Failover-Tests: Ein Failover, der nie getestet wurde, funktioniert im Ernstfall oft nicht. Regelmäßige Tests gehören genauso zum Konzept wie die Technik selbst.
Unklare Verantwortlichkeiten: Zwischen IT und Fachbereich muss klar sein, wer im Störfall was entscheidet — sonst kostet die Abstimmung mehr Zeit als der technische Failover.
Wie pronubes Hochverfügbarkeit unterstützt
Hochverfügbarkeit ist eine strategische Führungsaufgabe. CIOs, die Architektur, Betrieb, Beispiele aus der Praxis und typische Hürden ganzheitlich betrachten, schaffen eine stabile Grundlage für einen verlässlichen IT-Betrieb und eine zukunftsfähige Unternehmens-IT.
pronubes unterstützt dabei mit redundanten Architekturen, durchgängigem Monitoring und klaren Betriebsprozessen — abgestimmt auf die Anforderungen produzierender Unternehmen.
Ausfallzeiten, die man plant, statt die, die einen überraschen.
30 Minuten zu Ihrer Systemlandschaft: wo Redundanz heute fehlt, wie sich Hochverfügbarkeit sauber aufbauen lässt und woran sie in der Praxis meist scheitert.
pronubes is a product of inray Industriesoftware GmbH. Over 30 years of industrial software made in Germany. Innovative and reliable for manufacturing companies.
