Vom Shopfloor ins Lakehouse
Was Ihnen die Anbindung in pronubes bringt.
Maschinen- und Prozessdaten aus OPC UA, MQTT, SPS und SAP fließen ohne zusätzliche Middleware in Databricks oder einen eigenen Spark-Cluster. Drei typische Anwendungen im Überblick.
KI und ML auf aktuellen Produktionsdaten
Modelle mit Daten aus Ihrer Anlage speisen
Maschinen- und Prozessdaten werden kontinuierlich ins Lakehouse oder in Ihren Spark-Cluster geladen. KI/ML arbeitet damit auf aktuellen Produktionsdaten.
Analytics und Reporting
Berichte auf kontinuierlich geladenen Daten
Analytics und Reporting greifen auf Produktionsdaten zu, die kontinuierlich in Databricks oder Spark ankommen. Die Anbindung richten Sie wie bei jedem Datenbank-Connector ein.
Ergebnisse zurück in Richtung Produktion
Der Kreis schließt sich
Vorhersagen, Sollwerte und Stammdaten aus dem Lakehouse gelangen über einen konfigurierten Flow kontrolliert zurück in Richtung Produktion.
Gut zu wissen
Offen gesagt: Voraussetzungen und Grenzen
Zeit, Ihre Produktionsdaten in Bewegung zu bringen
In einem kurzen Gespräch zeigen wir Ihnen, was davon in Ihrer Systemlandschaft den größten Hebel hat.
Häufige Fragen
Brauche ich Programmier- oder SQL-Kenntnisse?
Nein. Die Anbindung richten Sie wie jeden Datenbank-Connector ein, ganz ohne SQL-Kenntnisse. pronubes Edge nutzt einen eigenen Treiber, eine Java-Laufzeit ist nicht nötig.
Welche Daten kann ich nach Databricks oder Spark übertragen?
Maschinen- und Prozessdaten aus OPC UA, MQTT, SPS und SAP-Flows fließen ohne zusätzliche Middleware in Databricks oder einen eigenen Spark-Cluster.
Können Ergebnisse zurück in die Produktion gelangen?
Ja. Vorhersagen, Sollwerte und Stammdaten aus dem Lakehouse gelangen über einen konfigurierten Flow kontrolliert zurück in Richtung Produktion.
Gibt es Einschränkungen?
Ja. Die native Windows-Installation von pronubes Edge ist derzeit eine Preview, Update und Delete funktionieren nur auf Delta-Tabellen, Kerberos nur mit Transport „Binary“, und komplexe Spark-Typen kommen als Text.
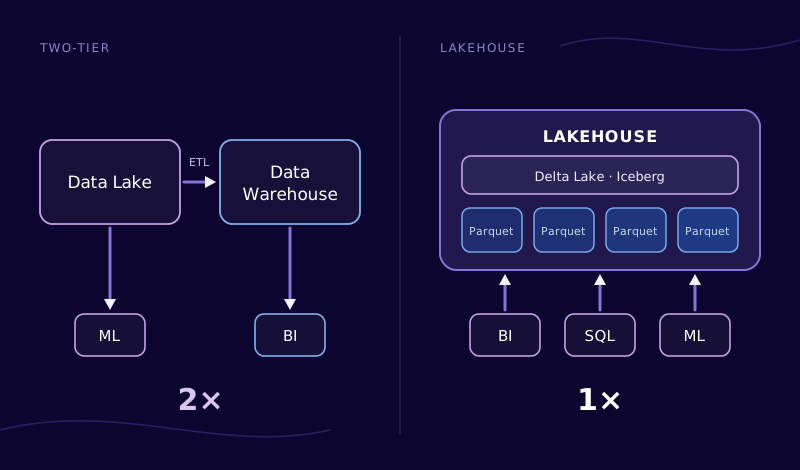 Data Lakehouse Ein Speicher für Analysen und KI Weiterlesen
 Industrial AI & Machine Learning Künstliche Intelligenz und maschinelles Lernen in der Produktion Weiterlesen
 InfluxDB 3: Anwendungsfälle Zeitreihen nativ, ohne Umweg Weiterlesen