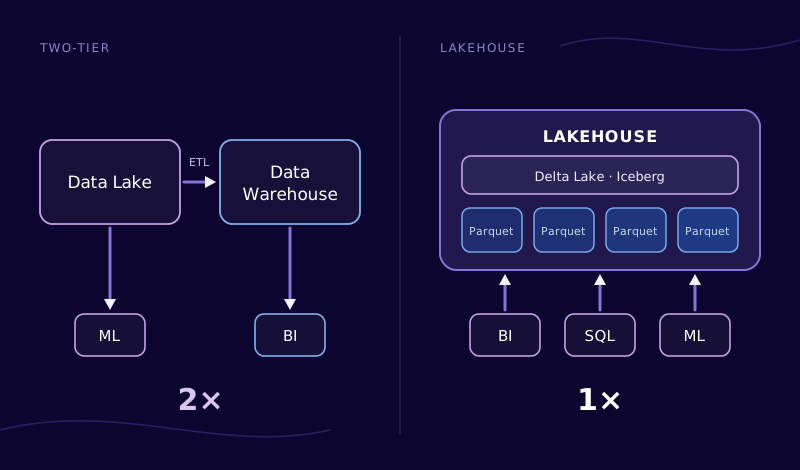
Ein Data Lakehouse verbindet die günstige, offene Ablage eines Data Lake mit Eigenschaften eines Data Warehouse: Transaktionen, Schema-Prüfung und schnelle Abfragen. Die Daten liegen einmal in offenen Dateiformaten wie Apache Parquet, und Reporting, Analytics und maschinelles Lernen greifen auf dieselbe Kopie zu. Das spart doppelte Datenhaltung, ersetzt aber weder ein Datenmodell noch die Arbeit an der Datenqualität. Ein Data Lakehouse ist eine Datenarchitektur, die zwei bisher getrennte Welten zusammenführt. Aus dem Data Lake übernimmt sie die Ablage beliebiger Daten in offenen Dateiformaten auf günstigem Objektspeicher. Aus dem Data Warehouse übernimmt sie Transaktionen, ein geprüftes Schema und Abfragen, die schnell genug für Berichte sind. Möglich macht das eine Tabellenschicht über den Dateien, etwa Delta Lake oder Apache Iceberg. Den Begriff Data Lake prägte James Dixon, damals Technikchef von Pentaho, im Jahr 2010: ein großer Speicher für Rohdaten, die erst beim Lesen eine Struktur bekommen. In der Praxis entstand daraus oft eine zweistufige Architektur. Rohdaten landen im Lake, ausgewählte Daten werden per Ladejob in ein Warehouse kopiert, damit Berichte schnell und verlässlich laufen. Jede Kopie braucht Pflege, und jede Kopie ist ein Stück älter als die Quelle. Am 30. Januar 2020 beschrieb Databricks das Lakehouse in einem Blogbeitrag als Antwort darauf. Auf der Konferenz CIDR 2021 folgte der Fachaufsatz von Michael Armbrust, Ali Ghodsi, Reynold Xin und Matei Zaharia. Er nennt die Schwächen der zweistufigen Architektur beim Namen: veraltete Daten, Zuverlässigkeit, Gesamtkosten, Bindung an einen Anbieter und begrenzte Unterstützung für maschinelles Lernen. Was veraltete Daten konkret bedeuten, zeigt eine Überschlagsrechnung. Rein zur Illustration: Lädt ein nächtlicher Job um 2:00 Uhr die Daten des Vortags ins Warehouse, erscheint ein Messwert von 2:05 Uhr erst knapp 24 Stunden später im Bericht. Über den Tag gemittelt liegt die Verzögerung bei rund 12 Stunden. Schreibt die Produktion direkt in eine Lakehouse-Tabelle, entfällt der Ladeschritt, und die Verzögerung hängt nur noch davon ab, wie oft Daten übertragen werden. Die Zahlen sind ein Rechenbeispiel, kein Messwert aus einem Projekt. Ein Lakehouse ist kein einzelnes Produkt, sondern ein Zusammenspiel offener Bausteine. Vier Mechanismen tragen die Architektur. Die Reihenfolge ist bei den meisten Vorhaben ähnlich. Welche Auswertungen sollen entstehen, und welche Maschinen, Anlagen und Systeme liefern die Daten dafür? Daten kommen unverändert und mit Herkunft in die erste Schicht. So bleibt jede spätere Auswertung nachvollziehbar. Dubletten entfernen, Einheiten und Zeitstempel vereinheitlichen, Messwerte mit Anlage, Auftrag und Schicht verknüpfen. Kennzahlen, Berichte und Modelle entstehen auf der geprüften Schicht. Ergebnisse wie Vorhersagen oder Sollwerte können zurück in Richtung Produktion gehen. Vier Abgrenzungen verhindern falsche Erwartungen. Diese Punkte bremsen Lakehouse-Projekte in der Fertigung am häufigsten. Ein Lakehouse löst das Problem doppelter Datenhaltung, nicht das Problem unklarer Daten. Wer heute ein Warehouse und einen Lake pflegt, hat nach der Umstellung nicht automatisch weniger Arbeit: Der Aufwand verlagert sich von Kopierjobs hin zu Tabellenpflege, Berechtigungen und Datenmodell. Dieser Aufwand ist besser investiert, aber er bleibt. Für ein Lakehouse übernimmt pronubes den Weg der Daten aus der Produktion und zurück. Die Produktteile haben dabei unterschiedliche Aufgaben. Ein Data Lake speichert Rohdaten ohne festes Schema und ohne Transaktionen. Ein Data Lakehouse legt eine Tabellenschicht darüber, die Transaktionen, Schema-Prüfung und Versionen ermöglicht. Dadurch eignet es sich auch für Berichte, ohne die Daten in ein Warehouse zu kopieren. Databricks stellte das Lakehouse am 30. Januar 2020 in einem Blogbeitrag vor. Der Fachaufsatz von Armbrust, Ghodsi, Xin und Zaharia erschien zur Konferenz CIDR 2021. Nein. Das Lakehouse ist ein Architekturmuster. Offene Tabellenformate wie Delta Lake und Apache Iceberg werden von verschiedenen Engines und Anbietern unterstützt. Für Historie, Auswertungen und maschinelles Lernen ja. Für Steuerung und Reaktionen in Millisekunden nein. Hochfrequente Daten sollten gebündelt geschrieben werden, damit nicht zu viele kleine Dateien entstehen. Die drei Schichten der Medallion-Architektur: Bronze enthält Rohdaten, Silber bereinigte und verknüpfte Daten, Gold auswertungsfertige Kennzahlen und Modelle. pronubes bringt Maschinen- und Prozessdaten ohne zusätzliche Middleware in Databricks oder Ihren Spark-Cluster und Ergebnisse kontrolliert zurück in Richtung Produktion.Was ist ein Data Lakehouse und wofür braucht man es in der Industrie?
Definition: Data Lakehouse
Merkmal
Data Warehouse
Data Lake
Data Lakehouse
Ablage
Strukturierte Tabellen, meist im Speicher des Anbieters
Dateien jeder Art im Objektspeicher
Offene Dateien im Objektspeicher plus Tabellenschicht
Schema
Wird vor dem Schreiben festgelegt
Wird erst beim Lesen angewendet
Wird beim Schreiben geprüft und lässt sich kontrolliert ändern
Transaktionen
Ja
Nicht vorgesehen
Ja, über das Tabellenformat
Typische Nutzung
Reporting und BI
Rohdatenarchiv, Data Science
Reporting, Analytics und ML auf denselben Daten
Datenformat
Meist herstellerspezifisch
Offen, etwa Parquet, JSON, CSV
Offen, etwa Parquet mit Delta Lake oder Iceberg
Warum das Lakehouse entstanden ist
Aus welchen Bausteinen ein Lakehouse besteht
Baustein
Aufgabe
Herkunft
Apache Parquet
Spaltenorientiertes Dateiformat für große Datenmengen
Top-Level-Projekt der Apache Software Foundation seit 27. April 2015
Delta Lake
Tabellenformat mit Transaktionen, Schema-Prüfung und Zugriff auf frühere Versionen
Von Databricks am 24. April 2019 als Open Source veröffentlicht, seit Oktober 2019 Projekt der Linux Foundation
Apache Iceberg
Offenes Tabellenformat, ursprünglich bei Netflix entstanden
Apache Incubator ab 16. November 2018, Top-Level-Projekt seit 20. Mai 2020
Abfrage-Engine
Liest und schreibt die Tabellen, führt SQL und ML-Workloads aus
Mehrere Engines können dieselben Tabellen nutzen, etwa Apache Spark
Medallion-Schichten
Ordnen Daten nach Reifegrad in Bronze, Silber und Gold
Entwurfsmuster, beschrieben in der Databricks-Dokumentation
Wie ein Lakehouse technisch funktioniert
In vier Schritten zum Lakehouse
Fragen und Quellen klären
Rohdaten laden (Bronze)
Bereinigen und anreichern (Silber)
Auswerten und zurückspielen (Gold)
Was ein Data Lakehouse nicht ist
Typische Hürden in der Praxis
Wie pronubes unterstützt
Häufige Fragen
Was ist der Unterschied zwischen Data Lake und Data Lakehouse?
Wer hat das Konzept beschrieben?
Brauche ich Databricks für ein Lakehouse?
Eignet sich ein Lakehouse für Maschinendaten?
Was bedeuten Bronze, Silber und Gold?
Ein Lakehouse lebt von Daten, die mit Kontext ankommen.
pronubes is a product of inray Industriesoftware GmbH. Over 30 years of industrial software made in Germany. Innovative and reliable for manufacturing companies.
