Künstliche Intelligenz in der OT
Künstliche Intelligenz in der OT bedeutet vor allem eine Entscheidung über den Ort: Wo darf ein Modell laufen, und wo darf es handeln? Trainiert wird ein Modell meist zentral, weil dort Rechenleistung und Historie liegen. Betrieben wird es meist am Rand des Netzwerks, direkt neben der Maschine, weil dort Millisekunden zählen und Prozessdaten das Werksgelände nicht verlassen müssen. Die eigentliche Arbeit liegt dazwischen: aus einer Vorhersage eine Handlungsempfehlung zu machen, der ein Mensch — und irgendwann die Maschine selbst — vertrauen kann.
Wo eine Entscheidung fällt: Edge oder Cloud
Künstliche Intelligenz in der Produktion lässt sich an zwei Orten betreiben: zentral in der Cloud oder lokal an der Anlage, am sogenannten Edge. Die Wahl ist keine Geschmacksfrage, sondern folgt aus drei Anforderungen, die in der OT anders wiegen als im Büro.
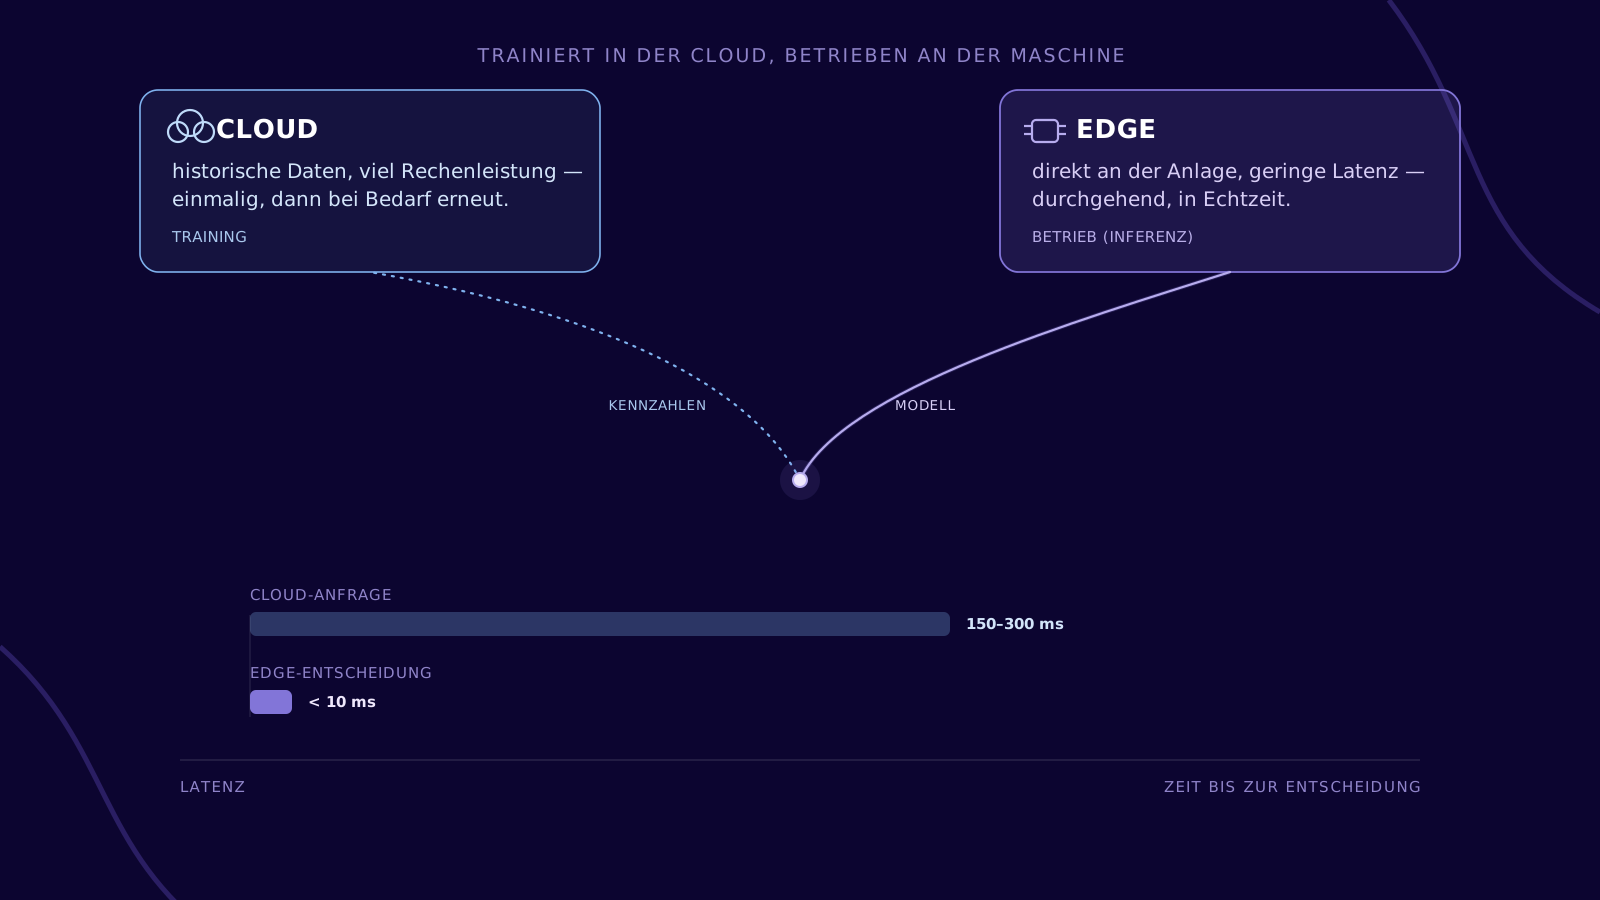
Erstens die Latenz. Eine Cloud-Anfrage braucht selbst unter guten Bedingungen einige zehn bis einige hundert Millisekunden für den Weg hin und zurück. Für eine Sichtprüfung, die die Anlage vor dem nächsten Takt stoppen soll, oder eine Regelung, die eine Drehzahl in Echtzeit nachführt, ist das häufig zu langsam. Eine lokale Entscheidung direkt am Gerät kostet dagegen nur die Zeit der Berechnung selbst.
Zweitens die Datenhoheit. Prozessdaten aus der Fertigung gehören zu den sensibelsten Daten eines Unternehmens — sie verraten Rezepturen, Taktzeiten und Auslastung. Wer sie lokal verarbeitet, muss sie nicht in ein fremdes Rechenzentrum senden, um von ihnen zu profitieren. Das ist besonders dort relevant, wo vertragliche Vorgaben von Kunden, Zulassungen oder der Status als Betreiber kritischer Infrastruktur festlegen, wo Daten liegen dürfen.
Drittens die Verfügbarkeit. Eine Edge-Anwendung läuft weiter, wenn die Internetverbindung ausfällt — eine Cloud-Anwendung nicht. In einer Produktion, die rund um die Uhr läuft, ist das kein Randfall, sondern ein Betriebszustand, der irgendwann eintritt.
Das heißt nicht, dass Cloud-KI in der OT nichts zu suchen hat. Es heißt, dass die Frage vor dem Projekt beantwortet werden muss, nicht danach.
Ein Modell muss nicht dort laufen, wo es entstanden ist. Es muss dort laufen, wo seine Entscheidung gebraucht wird — und das ist in der Fertigung selten ein Rechenzentrum.
Trainiert in der Cloud, betrieben an der Maschine
In der Praxis ist die Antwort meistens beides, nur zu unterschiedlichen Zeitpunkten. Das Training eines Modells — das Lernen aus großen Mengen historischer Daten — braucht Rechenleistung, die sich zentral leichter bereitstellen lässt: viele Beispiele, viel Speicher, oft spezialisierte Hardware, die sich für einen einzelnen Standort kaum lohnt. Der Betrieb des fertig trainierten Modells — die sogenannte Inferenz, also die Anwendung auf neue, laufend eintreffende Werte — braucht dagegen wenig Rechenleistung, dafür aber Kontinuität und geringe Latenz. Das lässt sich lokal, auf kompakter Hardware direkt neben der Anlage, meist besser lösen als über eine ständige Cloud-Verbindung.
Diese Aufteilung ist keine Ausnahme, sondern die Regel:
| Phase | Wo | Braucht | Rhythmus |
|---|---|---|---|
| Training | Cloud oder zentrales Rechenzentrum | große historische Datenmengen, viel Rechenleistung | einmalig, dann bei Bedarf erneut |
| Betrieb (Inferenz) | Edge, direkt an der Anlage | wenig Rechenleistung, aber geringe Latenz | durchgehend, in Echtzeit |
| Überwachung | Edge oder zentral | laufende Vergleichswerte zwischen Vorhersage und Wirklichkeit | kontinuierlich |
Die dritte Zeile wird am häufigsten übersehen. Ein Modell, das niemand beobachtet, verliert unbemerkt an Genauigkeit — ein Effekt, der als Drift bekannt ist und im Detail in unserem Beitrag zu Industrial AI und Machine Learning beschrieben ist. Für die OT kommt eine zusätzliche Frage hinzu: Wer stellt sicher, dass ein einmal trainiertes Modell überhaupt zuverlässig auf die Edge-Geräte kommt — und zwar auf alle, nicht nur auf das erste?
Von der Beschreibung zur Handlungsempfehlung
Analysen in der Produktion durchlaufen typischerweise vier Reifegrade, die aufeinander aufbauen. Jede Stufe beantwortet eine andere Frage, und jede setzt die vorherige voraus.
Deskriptiv beantwortet, was passiert ist: ein Dashboard zeigt Temperaturverläufe, Stückzahlen, Stillstandszeiten. Diagnostisch beantwortet, warum es passiert ist: eine Korrelation zwischen einem Sensorwert und einem Ausschussanstieg. Prädiktiv beantwortet, was passieren wird: die klassische vorausschauende Instandhaltung, die einen Lagerausfall in zwei Wochen ankündigt. Präskriptiv beantwortet, was zu tun ist: nicht nur die Warnung, sondern der Vorschlag, die Drehzahl um fünf Prozent zu senken, um die Überhitzung zu vermeiden.
Die meisten Projekte in der OT bleiben bei den ersten beiden Stufen stehen — Dashboards und Berichte sind sichtbar und lassen sich leicht rechtfertigen. Der wirtschaftliche Sprung liegt jedoch zwischen Stufe drei und vier: Eine Vorhersage allein verändert noch keinen Ablauf. Erst die Handlungsempfehlung, die konkret genug ist, um befolgt zu werden, wirkt sich auf Ausschuss, Stillstand oder Energieverbrauch aus.
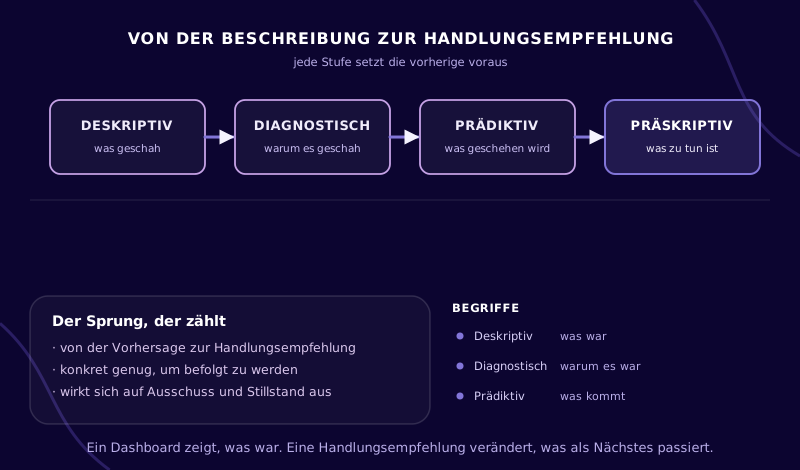
Jede Stufe setzt die vorherige voraus — ein Sprung direkt zur Handlungsempfehlung übersieht meist die Basis, auf der sie stehen müsste.
Skalierbare Intelligenz statt Insellösungen
Ein Modell, das auf einer Anlage funktioniert, ist noch keine Lösung — es ist ein Beweis, dass es grundsätzlich geht. Der Schritt zur Wirkung ist der zweite: dieselbe Intelligenz auf hunderte baugleiche Maschinen, mehrere Linien oder mehrere Standorte zu bringen, ohne für jede ein eigenes Projekt zu starten.
Zwei Bausteine machen das möglich. Der erste ist technisch: Wird ein Modell wie eine containerisierte Anwendung verpackt, lässt es sich unverändert auf unterschiedlichen Edge-Geräten ausrollen, zentral verwalten und bei Bedarf per Update austauschen — genau wie eine App auf einem Mobiltelefon, nur ohne App Store und ohne Nutzerinteraktion. Der zweite Baustein ist struktureller Natur und wird leicht übersehen: Ein Modell überträgt sich nur dann von Maschine eins auf Maschine zwei, wenn beide Maschinen ihre Werte gleich benennen. Heißt ein Wert an der einen Linie sps-3-db12-dw4 und an der baugleichen Nachbarlinie etwas anderes, muss das Modell für jede Anlage neu gebaut werden, statt einfach kopiert zu werden.
Wer beides löst — einheitliche Benennung und containerisierte Verteilung —, verwandelt ein einzelnes Pilotprojekt in eine Plattform. Wer nur das eine löst, bekommt entweder viele Insellösungen oder eine Verteilung ohne gemeinsame Sprache.
Wer am Ende entscheidet
Je näher eine KI an die Handlung rückt, desto mehr Vertrauen braucht sie — und Vertrauen entsteht selten auf einen Schlag. In der Praxis hat sich dafür eine Abstufung durchgesetzt.
Beim Human-in-the-loop schlägt das Modell eine Aktion vor, ein Mensch bestätigt sie, bevor sie ausgeführt wird — etwa ein Wartungsvorschlag, der erst nach Freigabe zum Auftrag wird. Beim Human-on-the-loop handelt das System innerhalb festgelegter Grenzen selbstständig, ein Mensch überwacht laufend und kann jederzeit eingreifen — etwa eine automatische Parameteranpassung, die sich in einem definierten Korridor bewegt und bei Überschreitung meldet statt selbst zu handeln.
Der Wechsel von der ersten zur zweiten Stufe ist kein technisches Upgrade, sondern eine organisatorische Entscheidung, die auf nachgewiesener Zuverlässigkeit beruht — nicht auf der Genauigkeit im Testlauf, sondern auf der Erfahrung im laufenden Betrieb über Zeit.
Eine Grenze bleibt davon unberührt: Funktionale Sicherheit wird nicht gelernt. Ein Modell darf beobachten, warnen und vorschlagen; abschalten darf im Zweifel weiterhin die dafür zertifizierte Sicherheitstechnik. Wie die europäische KI-Verordnung KI-Systeme in der Fertigung einordnet, behandelt unser Beitrag zu Industrial AI und Machine Learning im Detail.
Umsetzung mit pronubes
pronubes liefert kein KI-Modell. Die Plattform liefert die Infrastruktur, ohne die ein Modell in der OT weder verlässlich mit Daten versorgt noch kontrolliert zur Wirkung gebracht wird.
pronubes Edge bindet Maschinen, Sensoren und Systeme über Standardkonnektoren an — OPC UA, MQTT, REST, SQL, Dateiformate — und eignet sich als Ort, an dem ein trainiertes Modell nahe an der Anlage läuft, statt jede Anfrage über das Werksnetz hinaus zu schicken.
pronubes Zones hält die einheitliche Benennung, die ein Modell von der ersten auf die zweite Anlage überträgt — die Voraussetzung für die Skalierung aus dem vorherigen Abschnitt.
pronubes Insights zeigt, welche Quelle liefert, welche schweigt und wie aktuell ein Wert ist — die Überwachung der Eingangsdaten, ohne die weder Drift noch ein stiller Ausfall auffällt.
Für die Anbindung an KI- und Analyseplattformen wie Snowflake lassen sich Produktionsdaten strukturiert und nahezu in Echtzeit übergeben. Über einen MCP Server lassen sich relevante Produktionsdaten, Kontextinformationen und Funktionen zusätzlich standardisiert für KI-Anwendungen und Agents bereitstellen — damit ein Modell nicht nur Zahlen bekommt, sondern den Kontext aus der realen Produktion, der sie erst verständlich macht.
Der Nutzen einer KI in der OT zeigt sich nicht im ersten Modell auf der ersten Maschine, sondern darin, wie schnell die zweite folgt.
- Edge-KI
- Ausführung eines KI-Modells direkt am Ort der Datenentstehung, statt in einem zentralen Rechenzentrum.
- Inferenz
- Die Anwendung eines bereits trainierten Modells auf neue Daten — im Unterschied zum Training, bei dem das Modell erst lernt.
- Präskriptive Analytik
- Die Stufe, die aus einer Vorhersage eine konkrete Handlungsempfehlung ableitet, statt nur ein Ereignis anzukündigen.
- Human-in-the-loop
- Ein Mensch bestätigt eine von der KI vorgeschlagene Aktion, bevor sie ausgeführt wird.
- Human-on-the-loop
- Die KI handelt innerhalb festgelegter Grenzen selbstständig, ein Mensch überwacht und kann eingreifen.
- Containerisierung
- Eine Anwendung so verpackt, dass sie unverändert auf vielen unterschiedlichen Geräten läuft und sich zentral verwalten lässt.
Häufige Fragen
Muss KI in der OT zwingend am Edge laufen?
Nein. Für Auswertungen ohne Echtzeitanspruch — etwa eine wöchentliche Qualitätsanalyse über mehrere Standorte — spricht wenig gegen die Cloud. Sobald Millisekunden zählen oder Daten das Werksgelände nicht verlassen sollen, wird der Edge-Betrieb zur Voraussetzung, nicht zur Option.
Was passiert, wenn die Internetverbindung ausfällt?
Ein am Edge betriebenes Modell arbeitet weiter, weil die Entscheidung lokal fällt. Betroffen ist nur, was ohnehin auf Verbindung angewiesen ist: ein Modell-Update, der Abgleich mit zentralen Systemen oder das Nachtrainieren.
Ab wann darf eine KI selbstständig eingreifen?
Erst nach einer Phase als Human-in-the-loop, in der sich zeigt, wie zuverlässig die Vorschläge tatsächlich sind. Funktionale Sicherheit bleibt davon unabhängig immer bei zertifizierter Sicherheitstechnik, nicht beim Modell.
Wie unterscheidet sich das von klassischer Automatisierung?
Klassische Automatisierung folgt einer fest programmierten Regel. Ein KI-Modell leitet die Regel aus Daten ab und kann sich anpassen, wenn sich der Prozess ändert — braucht dafür aber laufende Beobachtung, die eine feste Regel nicht braucht.
Was hat das mit dem AI Act zu tun?
Die Einstufung hängt an der Zweckbestimmung, nicht am Einsatz von KI an sich. Ein Modell, das Instandhaltung plant, fällt in der Regel nicht unter die Hochrisiko-Kategorien der europäischen KI-Verordnung; ernst wird es dort, wo ein Modell in eine Sicherheitsfunktion eingreift. Details dazu in unserem Beitrag zu Industrial AI und Machine Learning.
KI, die auch am Edge zuverlässig entscheidet.
30 Minuten zu Ihrer Systemlandschaft: wo Ihre KI heute läuft — und wo sie laufen sollte.
pronubes is a product of inray Industriesoftware GmbH. Over 30 years of industrial software made in Germany. Innovative and reliable for manufacturing companies.
