Was ist ein Data Lake?
Ein Data Lake ist ein zentraler Speicher, der Rohdaten aus beliebigen Quellen in ihrem Ursprungsformat aufnimmt — strukturiert, teilstrukturiert und unstrukturiert nebeneinander. Anders als ein Data Warehouse erzwingt er kein Schema beim Schreiben; die Struktur entsteht erst beim Lesen, je nach Anwendungsfall. Für Produktionsunternehmen heißt das: Maschinendaten, Bilder, Protokolle und Stammdaten landen an einem Ort, bevor feststeht, wozu sie später gebraucht werden. Ein Data Lake ist ein Speicherprinzip, kein fertiges Produkt.
Definition: Data Lake
Der Begriff Data Lake geht auf einen Blogbeitrag von James Dixon, damals Chief Technology Officer bei Pentaho, vom 14. Oktober 2010 zurück. Dixon stellte dem Data Mart — aufbereitet, gefiltert, für eine einzelne Frage vorgeformt — den See gegenüber: ein großer Wasserkörper im natürlichen Zustand, aus dem sich jeder das nimmt, was er braucht, statt vorab in Flaschen abgefüllt zu bekommen.
Technisch beschreibt ein Data Lake einen zentralen Speicher, der Daten in ihrem Ursprungsformat hält — Tabellen, Bilder, Protokolldateien, Freitext, Zeitreihen nebeneinander, unabhängig von der Quelle. Der Speicherort selbst ist meist ein Objektspeicher: günstig, praktisch unbegrenzt skalierbar, ohne die Struktur eines klassischen Dateisystems.
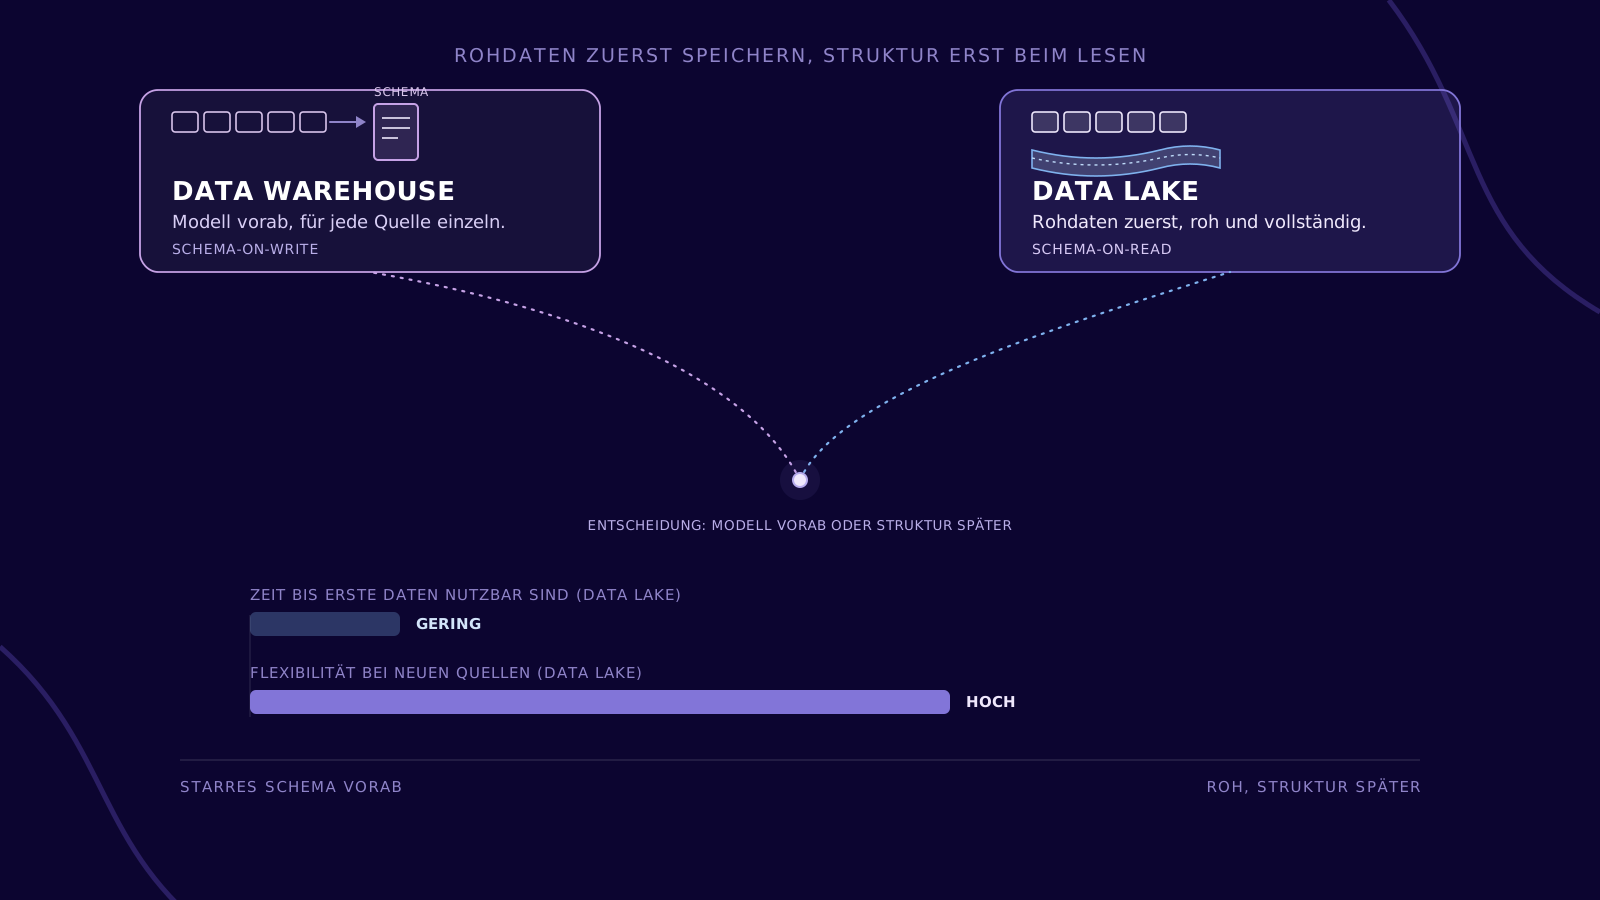
Der Unterschied zum Data Warehouse liegt am Zeitpunkt der Strukturierung: Ein Warehouse verlangt ein festes Schema, bevor Daten hineinkommen (Schema-on-Write) — jede neue Datenquelle ist ein Modellierungsprojekt. Ein Data Lake nimmt Daten roh auf und legt das Schema erst beim Lesen an (Schema-on-Read) — die Frage, die eine Anwendung stellt, entscheidet über die Struktur, nicht ein Projekt Monate vorher.
| Merkmal | Data Warehouse | Data Lake |
|---|---|---|
| Schema | beim Schreiben (Schema-on-Write) | beim Lesen (Schema-on-Read) |
| Datentypen | strukturiert, tabellarisch | strukturiert, teilstrukturiert, unstrukturiert |
| Aufnahme neuer Quellen | Modellierung vorab nötig | Rohdaten sofort ablegbar |
| Typische Nutzung | Standardberichte, feste Kennzahlen | Exploration, Machine Learning, Historie |
Warum Rohdaten zuerst gespeichert werden
In einem Produktionsunternehmen laufen Daten zusammen, die keinem gemeinsamen Schema folgen: Zeitreihen aus der Steuerung, Prüfbilder aus der optischen Qualitätskontrolle, PDF-Zertifikate von Lieferanten, Stammdaten aus dem ERP, Freitext aus Störungsmeldungen. Ein Data Warehouse verlangt für jede dieser Quellen ein Modell, bevor der erste Datensatz ankommt — bei fünf Quellen fünf Modellierungsprojekte, von denen keines beginnen kann, solange nicht feststeht, wofür die Daten später gebraucht werden.
Ein Data Lake kehrt die Reihenfolge um: Die Daten kommen roh und vollständig herein, die Frage nach ihrer Struktur wird verschoben, bis eine Anwendung sie tatsächlich stellt. Das kostet nichts an Objektspeicher — der ist günstig genug, um auch Daten zu halten, für die es noch keinen Anwendungsfall gibt — und es verhindert, dass ein Modellierungsprojekt zur Voraussetzung für den ersten Blick in die Daten wird.
Damit ergänzt der Data Lake ein Ordnungsprinzip wie den Unified Namespace: Ein Namensraum hält den aktuellen Stand jeder Quelle, ohne Verlauf. Historische Werte, die er nicht vorhält, brauchen einen Ort zum Absetzen — genau das ist die Aufgabe des Data Lake.
Wie ein Data Lake aufgebaut ist
Ein Data Lake schreibt keine Struktur vor — genau das macht ein völlig unstrukturiertes Ablegen so verlockend und so riskant zugleich. In der Praxis hat sich deshalb ein Schichtmodell durchgesetzt, das Rohdaten in mehreren Stufen zu nutzbaren Daten macht, ohne das Original zu verlieren. Am weitesten verbreitet ist die Medaillon-Architektur mit den Stufen Bronze, Silver und Gold — die Bezeichnungen stammen aus der Dokumentation von Databricks, sind aber inzwischen herstellerübergreifend gebräuchlich.
| Zone | Inhalt | Zielgruppe |
|---|---|---|
| Bronze (Rohzone) | Daten wie geliefert, unverändert, mit Herkunft und Zeitstempel | Dateningenieure, Nachvollziehbarkeit |
| Silver (bereinigte Zone) | bereinigt, dedupliziert, typisiert, zusammengeführt | Fachanwendungen, Analysten |
| Gold (veredelte Zone) | aggregiert, für eine konkrete Fragestellung geformt | Berichte, Dashboards, Machine Learning |
Der Vorteil liegt darin, dass jede Zone unabhängig neu berechnet werden kann, solange die Rohzone unverändert bleibt. Stellt sich später heraus, dass eine Bereinigungsregel falsch war, wird nicht neu erhoben, sondern aus der Bronze-Zone neu abgeleitet.
Die Zonenstruktur in der Praxis
Innerhalb jeder Zone brauchen Dateien einen Platz, der sich ohne Suchen wiederfindet. Bewährt hat sich eine Ordnung nach Quelle, Werksstruktur und Zeit — wer bereits einen Unified Namespace betreibt, erkennt das Muster wieder: auch hier zahlt sich eine einmal beschlossene, am Werk orientierte Benennung aus, angelehnt an dieselbe Gliederung nach ISA-95 / IEC 62264-1 (Enterprise, Site, Area, Work Center).
Ein Pfad in der Rohzone könnte so aussehen:
bronze/werk-nord/halle-2/linie-3/abfueller/2026-09-24/sensordaten.parquet
Und nach der Bereinigung in der Silver-Zone, thematisch statt technisch partitioniert:
silver/produktion/temperatur/jahr=2026/monat=09/
Drei Regeln haben sich bewährt: Partitionierung nach dem Merkmal, nach dem später am häufigsten gefiltert wird (meist Zeit); ein Dateiname, der die Herkunft erkennen lässt, ohne dass eine Anwendung ihn parsen muss; und ein Metadatenkatalog, der diese Struktur dokumentiert — ohne ihn ist die schönste Ordnung nur so lange bekannt, wie die Person da ist, die sie angelegt hat.
Object Storage, Parquet, Iceberg — woran ein Data Lake technisch hängt
Drei Schichten tragen einen Data Lake in der Praxis:
- Objektspeicher als Fundament: S3-kompatible Speichersysteme legen Dateien flach ab, ohne die Größenbeschränkungen und die Verwaltung eines klassischen Dateiservers.
- Apache Parquet als Dateiformat: ein spaltenorientiertes Format der Apache Software Foundation, das nur die tatsächlich gebrauchten Spalten liest statt ganzer Zeilen. Eine Tabelle mit 200 Spalten, aus denen eine Auswertung zehn braucht, liest damit ein Zwanzigstel der Daten — nicht das Zwanzigfache, wie es ein zeilenorientiertes Format tun würde.
- Offene Tabellenformate wie Apache Iceberg, Delta Lake oder Apache Hudi legen sich über Parquet-Dateien und bringen, was reiner Objektspeicher nicht kann: Schema-Änderungen ohne Neuschreiben aller Daten, Zeitreisen zu einem früheren Stand, und Transaktionssicherheit bei gleichzeitigen Schreibvorgängen. Ein Data Lake, der auf einem dieser Formate aufsetzt, wird in der Fachliteratur oft Lakehouse genannt — ein Data Lake mit den Transaktionsgarantien eines Data Warehouse.
Keine dieser Komponenten macht aus einem Datenordner einen Data Lake. Das tut erst der Metadatenkatalog: ein Verzeichnis, das zu jeder Tabelle und Datei festhält, woher sie stammt, welches Schema sie hat, wer sie pflegt und wie aktuell sie ist. Ohne Katalog lässt sich nicht unterscheiden, ob ein Ordner leer ist, weil es keine Daten gibt, oder weil niemand mehr weiß, dass es sie gibt.
Vier Schritte zum Data Lake
-
Zonen und Zuständigkeiten festlegen
Bronze, Silver, Gold — oder eine eigene Variante davon — werden benannt, und für jede Zone steht fest, wer sie verantwortet. Das ist die Entscheidung, die später am teuersten zu ändern ist.
-
Rohdaten anbinden
Quellen veröffentlichen unverändert in die Bronze-Zone — ohne Transformation, ohne Vorabauswahl. Was nicht ankommt, kann später nicht neu abgeleitet werden.
-
Bereinigen und katalogisieren
Duplikate, fehlerhafte Werte und uneinheitliche Formate werden in der Silver-Zone korrigiert, jede Tabelle im Metadatenkatalog eingetragen.
-
Für Anwendungen veredeln
Aus der Silver-Zone entstehen Gold-Tabellen für einen konkreten Zweck — ein Bericht, ein Dashboard, ein Trainingsdatensatz. Ein neuer Anwendungsfall bekommt eine neue Gold-Tabelle, keinen neuen Export aus der Quelle.
Was ein Data Lake nicht ist
- Kein Data Warehouse. Er ersetzt keine Standardberichte mit fester Struktur — dafür bleibt ein Warehouse oder eine Gold-Zone mit Warehouse-Charakter die bessere Wahl.
- Kein Ersatz für Echtzeitsysteme. Ein Data Lake liest historische Bestände, keine Millisekunden-Reaktion auf eine Anlage. Dafür bleiben Steuerung, MES und ein Namensraum wie der Unified Namespace zuständig.
- Kein Selbstläufer. Ohne Zonen, Katalog und Zuständigkeit entsteht kein Data Lake, sondern ein Ordner, in den alles hineinfließt und aus dem nichts mehr herausfindet.
- Kein Produkt. Es gibt keine Software, deren Installation einen Data Lake erzeugt — nur Software, die eine Zonenstruktur und einen Katalog gut oder schlecht trägt.
Typische Hürden in der Praxis
Bereits 2014 warnte das Analystenhaus Gartner in einer Pressemitteilung vor der „Data Lake Fallacy“ — der Annahme, ein Speicher allein schaffe schon Nutzen. Ohne Governance wird aus dem Data Lake ein Data Swamp: ein Speicher, in dem Daten liegen, aber niemand mehr weiß, welche vertrauenswürdig, aktuell oder überhaupt noch in Gebrauch sind. Die Warnung ist über zehn Jahre alt und in der Praxis noch immer die häufigste Ursache für gescheiterte Data-Lake-Vorhaben.
- Katalog fehlt oder veraltet. Tabellen ohne Eintrag sind schneller angelegt als gepflegt — und nach einem Jahr niemandem mehr zuzuordnen.
- Rohzone wird direkt angefragt. Wer Fachanwendungen auf die Bronze-Zone statt auf Silver oder Gold zugreifen lässt, verteilt Bereinigungslogik über jede einzelne Anwendung neu.
- Kein Lifecycle. Ohne Regeln, wann Rohdaten archiviert oder gelöscht werden, wächst der Speicher unbegrenzt — und mit ihm die Unübersichtlichkeit.
- Ungeklärte Zuständigkeit. Eine Zone ohne Verantwortlichen wird nicht betrieben, sondern nur repariert, wenn etwas auffällt.
Ein Data Lake lohnt sich nicht für jede Ausgangslage. Bei wenigen, gut strukturierten Quellen und einem festen Berichtskatalog leistet ein klassisches Data Warehouse dasselbe mit weniger Aufwand. Und ohne mindestens eine Person, die Zonen und Katalog dauerhaft pflegt, entsteht kein Data Lake, sondern der Data Swamp, vor dem Gartner bereits 2014 gewarnt hat.
Wie pronubes einen Data Lake trägt
pronubes ist die Plattform zwischen Shopfloor und IT. Sie erfasst Produktionsdaten sicher, normalisiert sie und führt sie in eine gemeinsame Struktur — und bringt Entscheidungen als Vorgaben zurück in die Prozesse.
- pronubes Edge sammelt Rohdaten an der Quelle ein, puffert bei Verbindungsverlust und veröffentlicht unverändert in die Rohzone.
- pronubes Zones bildet die Zonen- und Werksstruktur ab — dieselbe Benennung, die auch der Unified Namespace nutzt, wird gepflegt statt in Dokumenten verstreut.
- pronubes Insights macht Katalog und Datenqualität sichtbar: welche Tabelle wie aktuell ist und wo die Bereinigung noch aussteht.
Der Data Lake bleibt damit kein Ordner, sondern ein betriebener Bestandteil der Landschaft. Mehr zur Plattform
- Data Lake
- Zentraler Speicher für Rohdaten in ihrem Ursprungsformat, mit Struktur erst beim Lesen (Schema-on-Read).
- Data Warehouse
- Speicher mit festem Schema beim Schreiben, ausgelegt auf wiederkehrende Standardberichte.
- Lakehouse
- Data Lake mit einem offenen Tabellenformat, das Transaktionssicherheit und Schema-Änderungen eines Data Warehouse ergänzt.
- Object Storage
- Flacher, S3-kompatibler Speicher für Dateien beliebiger Größe und Art, ohne Dateisystem-Hierarchie.
- Apache Parquet
- Spaltenorientiertes Dateiformat der Apache Software Foundation für effiziente Auswertungen großer Datenmengen.
- Medaillon-Architektur
- Schichtmodell aus Bronze-, Silver- und Gold-Zone, das Rohdaten stufenweise in nutzbare Daten überführt.
- Data Swamp
- Ungeordneter, unkatalogisierter Data Lake, in dem sich Daten nicht mehr auffinden oder vertrauenswürdig einordnen lassen.
Häufige Fragen
Ist ein Data Lake dasselbe wie ein Cloud-Speicher?
Nein. Der Speicher ist nur das Fundament. Ein Data Lake entsteht erst durch Zonen, ein gepflegtes Schema pro Zone und einen Metadatenkatalog — ein Objektspeicher ohne diese drei Elemente ist ein Ordner, kein Data Lake.
Brauche ich Hadoop für einen Data Lake?
Nein, nicht mehr. Der Begriff entstand 2010 im Umfeld von Hadoop, doch heute genügen Objektspeicher, ein Dateiformat wie Parquet und ein offenes Tabellenformat wie Iceberg oder Delta Lake — ganz ohne eigenes Hadoop-Cluster.
Wie unterscheidet sich ein Data Lake von einem Lakehouse?
Ein Lakehouse ist ein Data Lake, dem ein offenes Tabellenformat Transaktionssicherheit, Schema-Änderungen ohne Neuschreiben und Zeitreisen zu einem früheren Stand hinzufügt — Eigenschaften, die klassische Data Lakes nicht boten.
Wie groß sollte der erste Ausschnitt sein?
So groß, dass eine Zone vollständig durchlaufen wird — von der Rohdatenaufnahme bis zu einer Gold-Tabelle, die tatsächlich genutzt wird — und so klein, dass er in Wochen und nicht in Quartalen steht.
Was passiert, wenn niemand die Zonen pflegt?
Der Speicher füllt sich weiter, aber die Bereinigungsregeln veralten, der Katalog bleibt lückenhaft, und niemand kann mehr sagen, welcher Tabelle zu trauen ist. Das Ergebnis ist der Data Swamp, den Gartner bereits 2014 beschrieben hat.
 Digitaler Zwilling in der Produktion Was ein Data Lake liefert, damit ein Zwilling Historie hat Weiterlesen
 Was ist IT/OT-Konvergenz? Die Grundfrage dahinter — falls Sie hier eingestiegen sind Weiterlesen
 Data-Driven Decision Making Was die eine Wahrheit im Alltag ändert Weiterlesen
Ein Data Lake, der beim zweiten Anwendungsfall noch trägt.
30 Minuten zu Ihrer Datenlandschaft: welche Quellen es gibt, wie die Zonen aussehen sollten und woran Data Lakes in der Praxis scheitern.
pronubes is a product of inray Industriesoftware GmbH. Over 30 years of industrial software made in Germany. Innovative and reliable for manufacturing companies.
