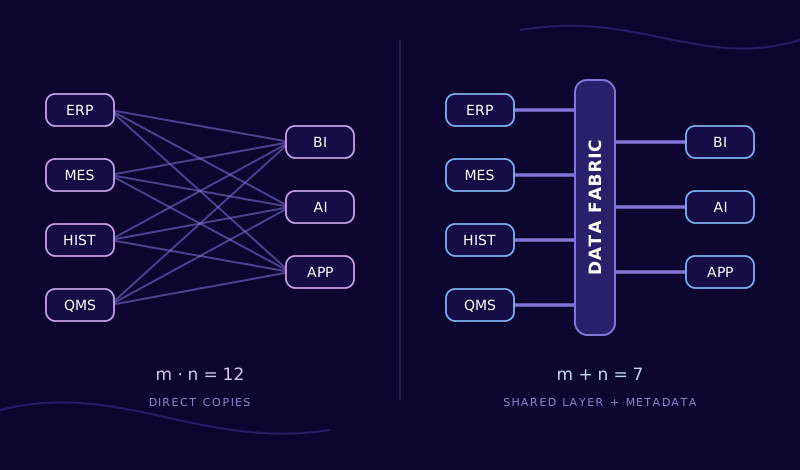
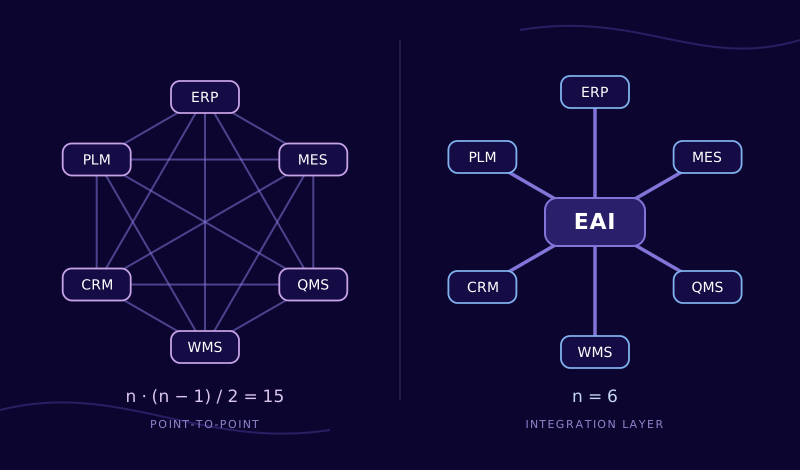
Eine Data Fabric ist ein Architekturkonzept, das verteilte Datenquellen über eine gemeinsame Schicht aus Metadaten, Integration und Zugriffsregeln nutzbar macht, ohne alle Daten an einen Ort zu kopieren. Die Daten bleiben in ERP, MES, Historian oder Cloud-Speicher. Die Fabric weiß, wo welche Daten liegen, was sie bedeuten und wer sie nutzen darf. In der Industrie hängt ihr Nutzen davon ab, ob die Daten aus der Produktion mit Kontext wie Anlage, Linie und Auftrag ankommen. Gartner beschreibt die Data Fabric als Designkonzept, das als integrierte Schicht aus Daten und verbindenden Prozessen dient. Grundlage ist eine fortlaufende Auswertung vorhandener und abgeleiteter Metadaten. So beschrieb es Gartner-Analyst Mark Beyer in einem Beitrag vom 25. August 2021. Gemeint ist kein einzelnes Produkt, sondern eine Architektur: Die Systeme bleiben, wie sie sind, und eine Schicht darüber regelt Auffinden, Zugriff und Bereitstellung. Daten aus der Produktion werden von immer mehr Stellen genutzt: Controlling, Qualität, Instandhaltung, Energiemanagement und zunehmend Analyse- und KI-Anwendungen. Häufig entsteht für jede Fragestellung eine eigene Verbindung oder eine eigene Kopie der Daten. Wie schnell das wächst, zeigt eine einfache Rechnung. Holt sich jeder von n Nutzern seine Daten selbst aus jeder von m Quellen, entstehen bis zu m · n Verbindungen. Bei 8 Quellen und 6 Nutzern sind das 48. Mit einer gemeinsamen Schicht braucht jede Quelle und jeder Nutzer nur einen Anschluss, zusammen m + n, hier also 14. Die Rechnung zeigt das Prinzip. In der Praxis braucht nicht jeder Nutzer jede Quelle, das Muster aus vielen Kopien mit unterschiedlichem Stand bleibt trotzdem das eigentliche Problem. Der Begriff selbst ist älter als der aktuelle Trend. Forrester veröffentlichte im vierten Quartal 2016 eine Marktübersicht zu „Big Data Fabric“ (Analyst Noel Yuhanna). Gartner zählte die Data Fabric zu den „Top Strategic Technology Trends for 2022“. Eine Data Fabric setzt sich aus wenigen Bausteinen zusammen. Sie müssen nicht von einem Hersteller kommen. Vier Mechanismen tragen die Architektur. Die Reihenfolge ist bei den meisten Vorhaben ähnlich. Welche Systeme liefern heute welche Daten an wen, auf welchem Weg und mit welcher Aktualität? Anlage, Linie, Auftrag und Material werden einheitlich benannt, damit Metadaten über Systemgrenzen hinweg stimmen. Ein klar abgegrenzter Bedarf, etwa Energiekennzahlen je Anlage, läuft als erster über die Fabric und wird gemessen. Weitere Quellen und Nutzer folgen nach Nutzen. Doppelte Kopien und Einzelverbindungen werden gezielt abgelöst. Vier Abgrenzungen verhindern falsche Erwartungen. Diese Punkte bremsen Data-Fabric-Vorhaben am häufigsten. Eine Data Fabric verlagert Arbeit, sie spart sie nicht ein. Statt vieler Ladeprozesse müssen Metadaten, Begriffe und Zugriffsregeln dauerhaft gepflegt werden. Bei wenigen Quellen und einem festen Berichtswesen ist ein gut geführtes Data Warehouse oft die einfachere Lösung. pronubes setzt am Anfang der Kette an: dort, wo Produktionsdaten entstehen und ihren Kontext bekommen. Die Produktteile haben dabei unterschiedliche Aufgaben. Die Data Fabric ist ein Architekturmuster, das verteilte Daten über Metadaten und eine gemeinsame Integrationsschicht zugänglich macht. Das Data Mesh ist vor allem ein Organisationsmodell, in dem Fachbereiche ihre Daten als Produkte verantworten. Viele Unternehmen nutzen Elemente aus beiden. Nein. Ein Data Warehouse oder ein Lakehouse kann Teil der Fabric sein. Die Fabric regelt, wie Daten aus diesen und anderen Quellen gefunden, beschrieben und bereitgestellt werden. Nein, das ist gerade nicht der Ansatz. Die Daten bleiben weitgehend in den Quellsystemen. Kopiert wird nur, wo Leistung, Verfügbarkeit oder Auswertung es erfordern. Sie gehören zu den wertvollsten und schwierigsten Quellen. Maschinendaten entstehen in hoher Frequenz und ohne fachlichen Kontext. Damit sie in der Fabric nutzbar sind, müssen sie im Werk angebunden, strukturiert und eindeutig zugeordnet werden. Mit einer Bestandsaufnahme der Quellen und Nutzer, einheitlichen Begriffen für zentrale Objekte und einem klar abgegrenzten Anwendungsfall. Die Werkzeugauswahl folgt daraus, nicht umgekehrt. pronubes bindet Maschinen und Systeme im Werk an und liefert Produktionsdaten mit Kontext an Ihre Datenplattform.Was ist eine Data Fabric und was bringt sie der Industrie?
Definition: Data Fabric
Merkmal
Zentrale Datenkopie
Data Fabric
Speicherort
Alle Daten werden in einen zentralen Speicher kopiert
Daten bleiben in den Quellsystemen, kopiert wird nur bei Bedarf
Bedeutung der Daten
Steckt in Ladeprozessen und Tabellenstrukturen
Steht in Metadaten und Beziehungen, die alle Nutzer sehen
Zugriffsregeln
Je Speicher neu festgelegt
Einmal definiert und für alle Zugriffswege angewendet
Neue Quelle
Neuer Ladeprozess in den zentralen Speicher
Anschluss an die Fabric und Beschreibung in den Metadaten
Typischer Einsatz
Wenige Quellen, festes Berichtswesen
Viele Quellen an mehreren Standorten, wechselnde Fragestellungen
Warum das Thema relevant wird
Die Bausteine einer Data Fabric
Baustein
Aufgabe
Herkunft
Metadatenkatalog
Verzeichnet, welche Daten es gibt, wo sie liegen und wem sie gehören
Kern der Data Fabric nach Gartner, 2021
Aktive Metadaten
Werten laufend aus, welche Daten wie genutzt werden, und steuern damit Bereitstellung und Qualität
Gartner, Mark Beyer, 25. August 2021
Wissensgraph
Bildet Beziehungen zwischen Datenobjekten ab, zum Beispiel Anlage, Auftrag und Material
Von Gartner als Baustein genannt, 2021
Integrationsdienste
Stellen Daten per Kopie, Datenstrom oder virtuellem Zugriff bereit
Integrationsstile nach Hohpe und Woolf, Enterprise Integration Patterns, 2003
Governance und Zugriff
Legen fest, wer welche Daten in welcher Form sehen darf
Bestandteil jeder Data-Fabric-Architektur
Wie eine Data Fabric technisch funktioniert
In vier Schritten zur Data Fabric
Quellen und Nutzer erfassen
Gemeinsame Begriffe festlegen
Mit einem Anwendungsfall beginnen
Schrittweise erweitern
Was eine Data Fabric nicht ist
Typische Hürden in der Praxis
Wie pronubes unterstützt
Häufige Fragen
Was ist der Unterschied zwischen Data Fabric und Data Mesh?
Ersetzt eine Data Fabric das Data Warehouse?
Muss man für eine Data Fabric alle Daten zentral speichern?
Welche Rolle spielen Produktionsdaten in einer Data Fabric?
Wie fängt man mit einer Data Fabric an?
Eine Data Fabric beginnt in der Produktion.
pronubes is a product of inray Industriesoftware GmbH. Over 30 years of industrial software made in Germany. Innovative and reliable for manufacturing companies.
