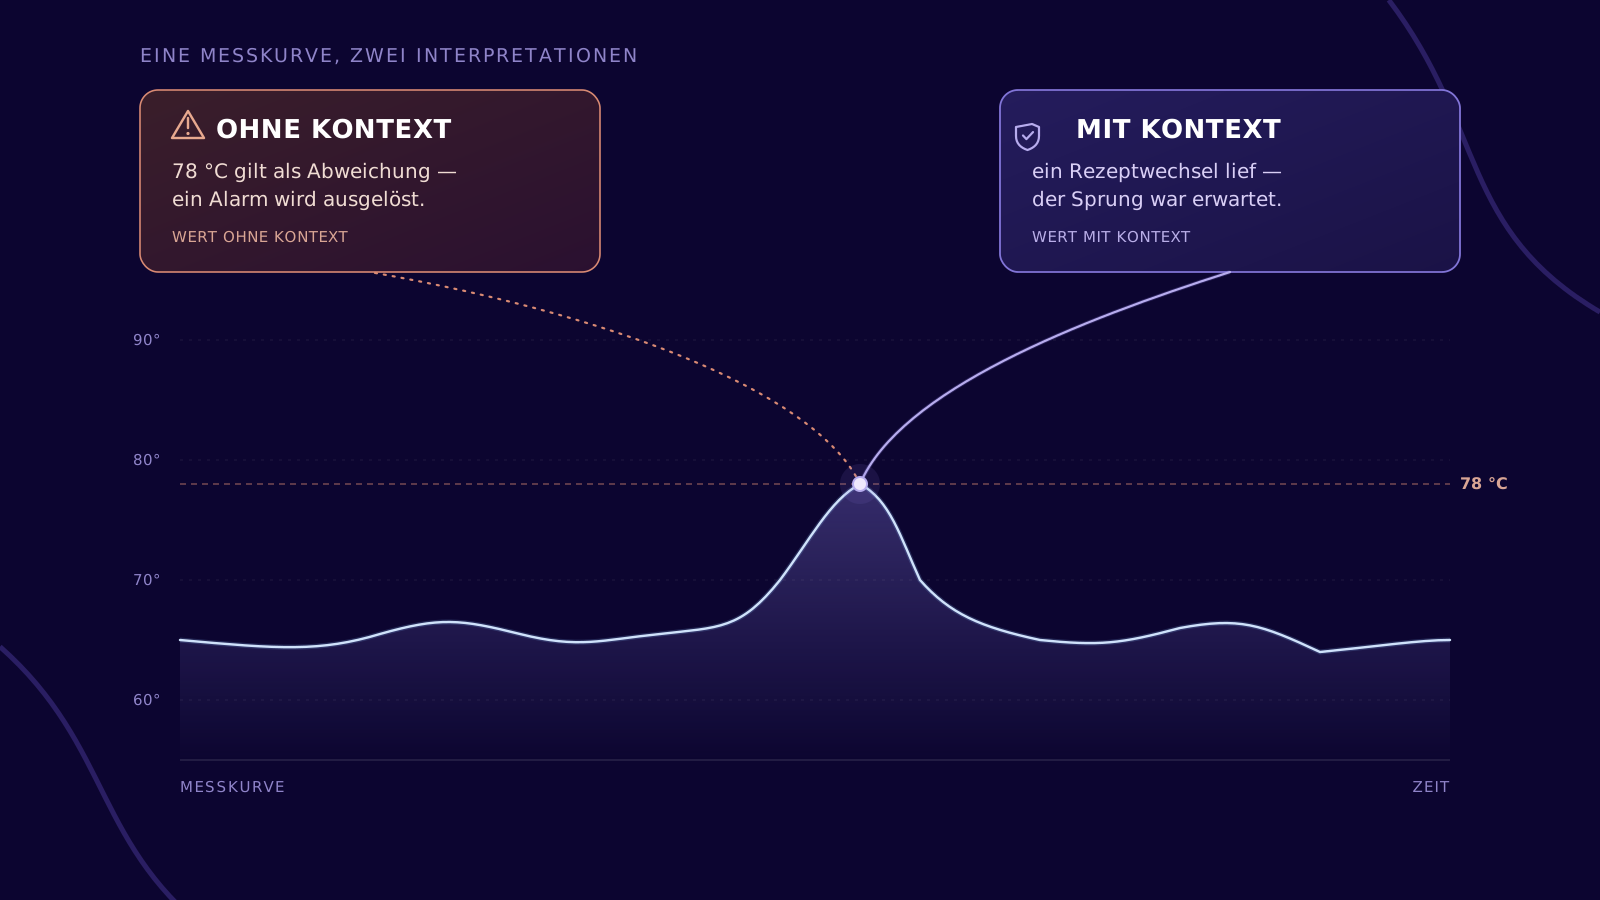
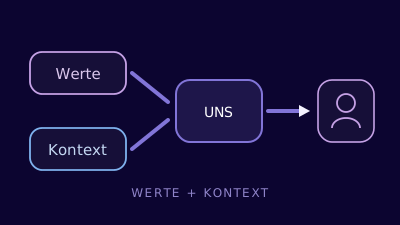
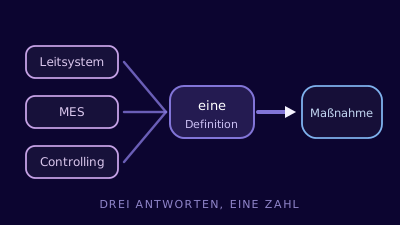
Industrial AI ist maschinelles Lernen auf Produktionsdaten — und unterscheidet sich von KI im Allgemeinen weniger durch die Verfahren als durch die Datenlage. Ein Modell sieht Messwerte, aber nicht die Anlage. Ob ein Temperatursprung ein Schaden oder ein geplanter Rezeptwechsel war, steht nicht im Wert, sondern daneben. Deshalb entscheidet in der Praxis selten der Algorithmus über den Erfolg, sondern die Frage, ob die Daten benannt, zeitlich sauber und im Nachhinein einem Ereignis zuzuordnen sind. Industrial AI bezeichnet maschinelles Lernen auf Daten aus Produktion und Anlagenbetrieb: Messwerte aus Steuerungen und Sensorik, Auftrags- und Materialdaten, Instandhaltungshistorie. Die Verfahren sind dieselben wie anderswo — Regression, Klassifikation, Anomalieerkennung, zunehmend auch Sprachmodelle für Dokumentation und Bedienung. Anders sind die Daten. Drei Eigenschaften machen den Unterschied. Produktionsdaten sind zeitbehaftet: Ein Wert ohne verlässlichen Zeitstempel lässt sich mit keinem anderen in Beziehung setzen. Das ist keine Feinheit. Es verschiebt den Aufwand eines Projekts von der Modellierung in die Datenarbeit davor — und erklärt, warum ein Verfahren, das im Notebook überzeugt, in der Halle scheitert. Ein Modell lernt nicht die Anlage. Es lernt die Regelmäßigkeiten in den Zahlen, die man ihm zeigt. Alles, was den Unterschied zwischen zwei gleich aussehenden Zahlen ausmacht, muss in den Daten stehen — sonst kann es das Modell nicht wissen und rät. Ein Temperaturwert von 78 °C an Sensor 4711 ist für sich genommen nichts. Nutzbar wird er, wenn feststeht, welches Aggregat ihn geliefert hat, welcher Auftrag lief, welches Material verarbeitet wurde und welcher Sollwert vorgesehen war. Diese Zuordnung heißt Kontext, und sie ist der Unterschied zwischen einem Alarm und einer Aussage. Fehlt sie, produziert ein Modell zuverlässig Fehlalarme — es meldet den Rezeptwechsel als Störung, weil der Rezeptwechsel für das Modell nicht existiert. Der Preis dafür ist nicht die Fehlmeldung selbst, sondern was sie auslöst: Nach dem dritten unbegründeten Alarm schaut die Schicht nicht mehr hin, und das Modell ist praktisch abgeschaltet, ohne dass es jemand abgeschaltet hätte. Kontext entsteht nicht in der Anlage. Er entsteht in einer Struktur, die Werte aus der Betriebstechnik mit Stammdaten aus der Informationstechnik zusammenführt und beides einheitlich benennt. Ein Unified Namespace ist genau dafür das Ordnungsprinzip: Er gibt jedem Wert einen Platz, der für alle Systeme gleich lautet — und damit auch für jedes Modell, das später darauf trainiert wird. Vier Stufen, bevor ein Modell etwas taugt — und der Rückweg, den niemand einplant. Die Anwendungsfälle unterscheiden sich weniger im Verfahren als in dem, was sie an Daten voraussetzen. Diese Tabelle ist deshalb nützlicher als eine Liste von Algorithmen: Sie beantwortet die Frage, ob ein Fall bei Ihnen überhaupt in Reichweite ist. Der einfachste Einstieg ist fast immer die Anomalieerkennung, weil sie ohne beschriftete Fehler auskommt: Sie lernt den Normalfall und meldet, was nicht dazu passt. Der schwierigste ist die Vorhersage von Restlaufzeiten, weil dafür Ausfälle gebraucht werden — und zwar aufgezeichnete. In den meisten Werken sind Ausfälle im Kopf der Instandhaltung dokumentiert und im Ticketsystem als „Anlage steht“. Die vier Stufen im Diagramm oben bauen aufeinander auf. Keine lässt sich überspringen, und jede kostet Arbeit, die vor dem ersten Modell anfällt. Der Wert liegt überhaupt vor, in bekannter Frequenz, und es fällt auf, wenn er ausbleibt. Eine Lücke, die niemand bemerkt, wird sonst als Messwert gelernt. Jeder Wert gehört zu genau einem Objekt in einer Struktur, die über Anlagen und Standorte hinweg gleich lautet. Ohne das ist kein Vergleich möglich — und ohne Vergleich kein Modell, das an einer zweiten Maschine funktioniert. Zeitstempel stammen aus einer gemeinsamen Quelle, und der Takt ist bekannt. Zwei Systeme mit fünf Minuten Uhrenversatz erzeugen Zusammenhänge, die es nicht gibt. Es ist festgehalten, was gut lief und was nicht — mit Zeitpunkt. Diese Stufe ist die unbeliebteste und die entscheidende: Ohne Label lernt ein Modell nur, wie der Betrieb aussieht, nicht, wann er aus dem Ruder läuft. Der typische Verlauf ist nicht das Scheitern, sondern das Steckenbleiben: Ein Pilot funktioniert an einer Maschine und lässt sich nicht auf die zweite übertragen. Die Ursachen sind meistens dieselben drei. Alle drei sind keine KI-Probleme. Sie sind Architekturprobleme, die sich unter dem KI-Projekt zeigen — und sie treten genauso auf, wenn statt eines Modells ein Dashboard gebaut wird. Wer sie vor dem ersten Modell löst, bekommt beides. Ein trainiertes Modell ist kein fertiges Ergebnis, sondern ein Bauteil im Betrieb. Es verliert an Genauigkeit, sobald sich unter ihm etwas ändert: ein neues Material, ein getauschter Sensor, eine andere Charge, ein umgebauter Prozessschritt. Dieser Effekt heißt Drift und ist der Normalfall, nicht die Ausnahme. Drei Dinge gehören deshalb von Anfang an dazu. Erstens eine Überwachung der Eingangsdaten: Wenn eine Quelle schweigt oder ihre Verteilung sich verschiebt, muss das auffallen, bevor die Vorhersagen still schlechter werden. Zweitens ein Vergleich mit der Wirklichkeit — was das Modell vorhergesagt hat und was eingetreten ist, nachgehalten über die Zeit. Drittens ein Weg zurück ins Training, der ohne Projekt auskommt. Das ist der unspektakuläre Teil, und er entscheidet, ob aus dem Piloten Betrieb wird. Ein Modell, das niemand beobachtet, ist gefährlicher als keines: Es liefert weiter Zahlen, und niemand merkt, dass sie nicht mehr stimmen. Nicht jede Frage in der Produktion braucht ein Modell, und einige verträgt sie nicht. Für die Einordnung als Hochrisiko-KI kennt die europäische KI-Verordnung zwei Wege. Der eine führt über Anhang III: dort sind Anwendungsbereiche aufgezählt — Biometrie, kritische Infrastruktur, Beschäftigung und weitere. Der andere führt Für die allgemeine Fertigung heißt das in der Regel: Ein Modell, das Instandhaltung plant oder Qualität prognostiziert, taucht in Anhang III nicht auf. Ernst wird es dort, wo das Modell in die Sicherheitsfunktion einer Maschine eingreift oder wo der Betrieb selbst zur kritischen Infrastruktur zählt — etwa in der Energie- oder Wasserversorgung. Die Einstufung hängt an der Zweckbestimmung und gehört in die juristische Prüfung, nicht in einen Fachartikel. Was sich technisch vorbereiten lässt, ist unabhängig davon dasselbe, was ein Modell ohnehin braucht: nachvollziehbare Datenherkunft, dokumentierte Struktur und aufgezeichnete Ergebnisse. pronubes liefert kein Modell. Die Plattform liefert die Datenlage, ohne die ein Modell nicht über den Piloten hinauskommt — dieselbe Grundlage, die auch Auswertung und Berichtswesen tragen. Der Nutzen zeigt sich nicht im ersten Modell, sondern im zweiten. Die Frage nach der Menge führt in die Irre. Entscheidend ist, ob der Zeitraum die Variation enthält, die das Modell später unterscheiden soll: verschiedene Materialien, Chargen, Schichten, Jahreszeiten. Ein Jahr mit sauberem Kontext ist mehr wert als fünf Jahre unbenannter Messwerte. Ja, aber nicht alles. Anomalieerkennung kommt ohne beschriftete Fehler aus, weil sie den Normalbetrieb lernt. Vorhersagen von Restlaufzeiten gehen ohne Ausfallhistorie nicht. Der sinnvolle erste Schritt ist deshalb oft, das Aufzeichnen von Ereignissen einzuführen — und ein Jahr später die Frage neu zu stellen. Für das Training häufig ja, weil dort Rechenleistung auf Abruf steht. Für den Betrieb häufig nein: Ein trainiertes Modell läuft in der Regel auch lokal. Die Frage entscheidet sich an der Latenz und an der Frage, welche Daten das Werk verlassen dürfen — nicht am Verfahren. Sie sind dort stark, wo Text die Arbeit ist: Anlagendokumentation durchsuchbar machen, Störungsmeldungen zusammenfassen, Bedienung in natürlicher Sprache. Für die Bewertung von Messreihen sind sie das falsche Werkzeug. Auch hier gilt: Ohne verlässliche Quelle antwortet ein Sprachmodell flüssig und falsch. Das ist die Frage, die vor dem Projekt geklärt werden muss und meistens danach gestellt wird. Ein Modell braucht jemanden, der die Eingangsdaten überwacht, Abweichungen bewertet und über das Nachtrainieren entscheidet — in der Regel dieselbe Stelle, die auch die Datenstrecke besitzt.Industrial AI und Machine Learning in der Produktion
Was Industrial AI von KI im Allgemeinen unterscheidet
Sie sind unvollständig beschriftet: Es gibt Millionen Messpunkte, aber selten eine Aufzeichnung, wann etwas schiefging und warum. Und sie sind kontextabhängig: Derselbe Zahlenwert bedeutet je nach Auftrag, Material und Betriebsart etwas anderes.Warum Kontext über den Nutzen entscheidet
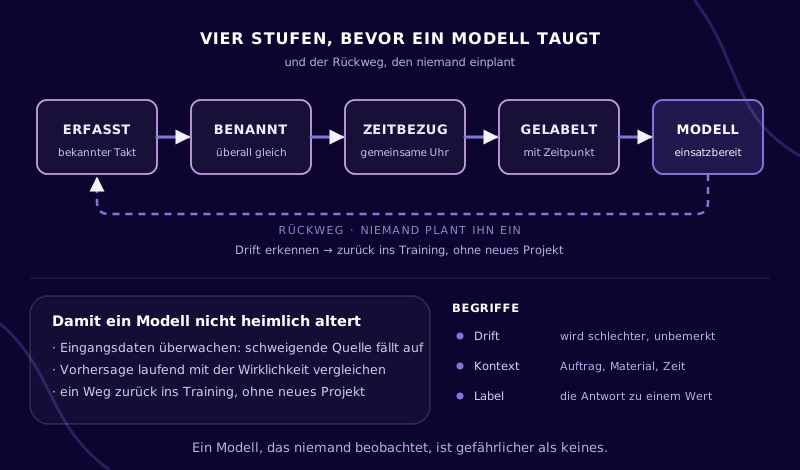
Vier Sorten von Anwendungsfällen
Anwendungsfall
Was das Modell tut
Was es voraussetzt
Anomalieerkennung
meldet, wenn ein Verlauf vom Gewohnten abweicht
lange, saubere Historie im Normalbetrieb
Zustandsbasierte Instandhaltung
schätzt, wie lange ein Bauteil noch trägt
Ausfälle, die als Ausfälle erfasst sind
Qualitätsvorhersage
rechnet vom Prozess auf das Ergebnis
Prüfergebnisse, dem Los eindeutig zugeordnet
Prozessoptimierung
schlägt Parameter vor
Variation in den Daten — und die Freigabe, sie zu nutzen
Was ein Modell an Daten voraussetzt
Erfasst
Benannt
Zeitlich eingeordnet
Gelabelt
Warum Piloten hängenbleiben
sps-3-db12-dw4 gelernt. An der Nachbarlinie heißt derselbe Wert anders, und das Modell muss neu gebaut werden statt kopiert.Ein Modell ist Software, die altert
Wo KI nicht die Antwort ist
Wie der AI Act industrielle Modelle einordnet
über Anhang I: Ein KI-System gilt als Hochrisiko, wenn es Sicherheitsbauteil eines dort erfassten Produkts ist und dieses Produkt einer Konformitätsbewertung durch Dritte unterliegt.Wie pronubes das Feld bereitet
Mehr zur Plattform
Häufige Fragen
Wie viele Daten braucht ein erstes Modell?
Wir haben keine dokumentierten Ausfälle. Geht trotzdem etwas?
Braucht Industrial AI die Cloud?
Was ist mit Sprachmodellen in der Produktion?
Wer betreibt das Modell später?
KI, die auf verlässlichen Daten aufbaut.
30 Minuten zu Ihrer Systemlandschaft: welche Datenbasis Industrial AI in der Praxis wirklich braucht.
pronubes ist ein Produkt der inray Industriesoftware GmbH. Seit über 30 Jahren Industriesoftware aus Deutschland. Innovativ und verlässlich für Produktionsunternehmen.
